基于docker部署redis四种模式

[TOC]

首先安装docker CentOS7安装docker

获取docker镜像 docker pull redis:[TAG]

一、单机部署

1.创建挂载目录

1
2
mkdir -p /data/redis/conf
mkdir -p /data/redis/data

2.添加配置文件

1
2
3
4
5
6
7
8
tee /data/redis/conf/redis.conf << EOF
# 设置服务端口 默认6379
port 6379
# 关闭保护模式,允许远程连接
protected-mode no
# 该redis远程连接用到的密码
requirepass 123456
EOF

3.启动redis

1
2
3
4
5
6
7
8
9
10
docker run -d \
-p 6379:6379 \
--name redis-server \
--restart always \
--privileged=true \
-v /etc/localtime:/etc/localtime \
-v /data/redis/conf/redis.conf:/etc/redis/redis.conf \
-v /data/redis/data:/data \
redis:[TAG] \
redis-server /etc/redis/redis.conf

二、主从复制部署

服务器信息

ip server name
172.19.0.101 master
172.19.0.102 slave1
172.19.0.103 slave2

1.分别创建挂载目录

1
2
3
4
5
6
mkdir -p /data/redis/master/conf
mkdir -p /data/redis/master/data
mkdir -p /data/redis/slave1/conf
mkdir -p /data/redis/slave1/data
mkdir -p /data/redis/slave2/conf
mkdir -p /data/redis/slave2/data

2.添加配置文件

主节点

1
2
3
4
5
6
7
8
tee /data/redis/master/conf/redis.conf << EOF
# 设置服务端口 6666
port 6666
# 关闭保护模式,允许远程连接
protected-mode no
# 该redis远程连接用到的密码
requirepass 123456
EOF

从节点

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
tee /data/redis/slave{1..2}/conf/redis.conf << EOF
# 服务端口 slave1 7777 slave2 8888 注意修改
port 7777
# 关闭保护模式,允许远程连接
protected-mode no
# 该redis远程连接用到的密码
requirepass 123456
# 主节点密码
masterauth 123456

# 配置主从复制 从节点默认只读
replicaof 192.168.1.101 6666
slave-read-only yes

#redis 5.0之前的版本配置主从复制用下面这个
# slaveof 192.168.1.101 6666

EOF

3.启动redis

master

1
2
3
4
5
6
7
8
9
10
docker run -d \
-p 6666:6666 \
--name redis-master \
--restart always \
--privileged=true \
-v /etc/localtime:/etc/localtime \
-v /data/redis/master/conf/redis.conf:/etc/redis/redis.conf \
-v /data/redis/master/data:/data \
redis:[TAG] \
redis-server /etc/redis/redis.conf

slave1

1
2
3
4
5
6
7
8
9
10
docker run -d \
-p 7777:7777 \
--name redis-slave1 \
--restart always \
--privileged=true \
-v /etc/localtime:/etc/localtime \
-v /data/redis/slave1/conf/redis.conf:/etc/redis/redis.conf \
-v /data/redis/slave1/data:/data \
redis:[TAG] \
redis-server /etc/redis/redis.conf

slave2

1
2
3
4
5
6
7
8
9
10
docker run -d \
-p 8888:8888 \
--name redis-slave2 \
--restart always \
--privileged=true \
-v /etc/localtime:/etc/localtime \
-v /data/redis/slave2/conf/redis.conf:/etc/redis/redis.conf \
-v /data/redis/slave2/data:/data \
redis:[TAG] \
redis-server /etc/redis/redis.conf

4.查看各个节点信息

查看master信息

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
[root@redis-master ~]# docker exec -it redis-master redis-cli -p 6666 -a 123456 info replication

Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
# Replication
role:master # 当前为主节点
connected_slaves:2 # 连接两个从节点
slave0:ip=172.19.0.102,port=7777,state=online,offset=42,lag=1 # 从节点1
slave1:ip=172.19.0.103,port=8888,state=online,offset=42,lag=1 # 从节点2
master_failover_state:no-failover
master_replid:f0214d7b9870fe4c5cbabdddf1ee743317ae74e5
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:42
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:42

查看slave1信息

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
[root@redis-slave1 ~]# docker exec -it redis-slave1 redis-cli -p 7777 -a 123456 info replication
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
# Replication
role:slave
master_host:172.19.0.101
master_port:6666
master_link_status:up
master_last_io_seconds_ago:10
master_sync_in_progress:0
slave_read_repl_offset:322
slave_repl_offset:322
slave_priority:100
slave_read_only:1
replica_announced:1
connected_slaves:0
master_failover_state:no-failover
master_replid:f0214d7b9870fe4c5cbabdddf1ee743317ae74e5
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:322
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:15
repl_backlog_histlen:308

查看slave2信息

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
[root@redis-slave2 ~]# docker exec -it redis-slave2 redis-cli -p 8888 -a 123456 info replication
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
# Replication
role:slave
master_host:172.19.0.101
master_port:6666
master_link_status:up
master_last_io_seconds_ago:7
master_sync_in_progress:0
slave_read_repl_offset:420
slave_repl_offset:420
slave_priority:100
slave_read_only:1
replica_announced:1
connected_slaves:0
master_failover_state:no-failover
master_replid:f0214d7b9870fe4c5cbabdddf1ee743317ae74e5
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:420
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:29
repl_backlog_histlen:392

5.测试主从复制

master

1
2
3
4
5
6
[root@redis-master ~]# docker exec -it redis-master redis-cli -p 6666 -a 123456 set name stave
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
OK # 成功写入数据
[root@redis-master ~]# docker exec -it redis-master redis-cli -p 6666 -a 123456 get name
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
"stave" # 成功读取

slave1

1
2
3
4
5
6
7
[root@redis-slave1 ~]# docker exec -it redis-slave1 redis-cli -p 7777 -a 123456 get name
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
"stave" # slave1 成功读取数据
[root@redis-slave1 ~]# docker exec -it redis-slave1 redis-cli -p 7777 -a 123456 set name stave
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
(error) READONLY You can't write against a read only replica.
# 由于从节点只读,所以写入数据报错

slave2

1
2
3
4
5
6
7
[root@redis-slave2 ~]# docker exec -it redis-slave2 redis-cli -p 8888 -a 123456 get name
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
"stave"
[root@redis-slave2 ~]# docker exec -it redis-slave2 redis-cli -p 8888 -a 123456 set name stave
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
(error) READONLY You can't write against a read only replica.
# 同slave1,可以成功读取数据但不能写入数据

三、哨兵部署

基于上面的主从模式

1.创建挂载目录

1
2
3
mkdir -p /data/redis/sentinel1/conf
mkdir -p /data/redis/sentinel2/conf
mkdir -p /data/redis/sentinel3/conf

2.添加配置文件

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
tee /data/redis/sentinel1/conf/sentinel.conf << EOF
port 6667
sentinel monitor mymaster 172.19.0.101 6666 2
sentinel auth-pass mymaster 123456
sentinel down-after-milliseconds mymaster 5000
sentinel parallel-syncs mymaster 1
sentinel failover-timeout mymaster 10000
EOF

tee /data/redis/sentinel2/conf/sentinel.conf << EOF
port 7778
sentinel monitor mymaster 172.19.0.101 6666 2
sentinel auth-pass mymaster 123456
sentinel down-after-milliseconds mymaster 5000
sentinel parallel-syncs mymaster 1
sentinel failover-timeout mymaster 10000
EOF

tee /data/redis/sentinel3/conf/sentinel.conf << EOF
port 8889
sentinel monitor mymaster 172.19.0.101 6666 2
sentinel auth-pass mymaster 123456
sentinel down-after-milliseconds mymaster 5000
sentinel parallel-syncs mymaster 1
sentinel failover-timeout mymaster 10000
EOF

sentinel monitor mymaster 2
mymaster :哨兵监控的master名称可以随便起
172.19.0.101 6666 ip和端口固定
2 quorum值,当哨兵是集群时,有多少个哨兵认为master失效(客观下线),master才算失效。 防止脑裂 配置计算最好是 哨兵总数量/2+1

这个 Sentinel 配置文件设置了 Redis Sentinel 的行为,以下是每个配置项的解析:

  1. **port 6667**:指定 Sentinel 实例监听的端口,默认是 26379。

  2. **sentinel monitor mymaster redis-master 6666 2**:

    • mymaster:设置被监控的主节点名称。
    • redis-master:主节点的主机名或 IP 地址。
    • 6666:主节点的端口号。
    • 2:表示在故障转移决策中需要的哨兵数量,意思是至少需要两个哨兵确认主节点故障才能进行故障转移。当哨兵是集群时,有多少个哨兵认为master失效(客观下线),master才算失效。 防止脑裂 配置计算最好是 哨兵总数量/2+1 ,哨兵模式是单节点时 此处为 1
  3. **sentinel auth-pass mymaster yourpassword**:配置 Sentinel 访问主节点的密码。如果 Redis 实例启用了密码保护,需要在这里指定。

  4. **sentinel down-after-milliseconds mymaster 5000**:设置 Sentinel 认为主节点不可用的时间阈值(以毫秒为单位),这里是 5000 毫秒(即 5 秒)。

  5. **sentinel parallel-syncs mymaster 1**:指定故障转移期间并行同步从节点的数量。在故障转移时,最多有 1 个从节点将被并行同步到新的主节点。

  6. **sentinel failover-timeout mymaster 10000**:设置故障转移超时(以毫秒为单位),这里是 10000 毫秒(即 10 秒)。在此时间内,Sentinel 需要完成故障转移过程。

这些配置项共同工作,以确保在主节点发生故障时,Sentinel 可以迅速检测到问题并完成自动故障转移。

3.启动sentinel

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
docker run -d \
-p 6667:6667 \
--name redis-sentinel1 \
--network redis-net \
-v /etc/localtime:/etc/localtime \
-v /data/redis/sentinel1/conf/sentinel.conf:/usr/local/etc/redis/sentinel.conf \
redis:7.0.0 \
redis-sentinel /usr/local/etc/redis/sentinel.conf

docker run -d \
-p 7778:7778 \
--name redis-sentinel2 \
--network redis-net \
-v /etc/localtime:/etc/localtime \
-v /data/redis/sentinel2/conf/sentinel.conf:/usr/local/etc/redis/sentinel.conf \
redis:7.0.0 \
redis-sentinel /usr/local/etc/redis/sentinel.conf

docker run -d \
-p 8889:8889 \
--name redis-sentinel3 \
--network redis-net \
-v /etc/localtime:/etc/localtime \
-v /data/redis/sentinel3/conf/sentinel.conf:/usr/local/etc/redis/sentinel.conf \
redis:7.0.0 \
redis-sentinel /usr/local/etc/redis/sentinel.conf

4.查看哨兵信息

1
2
3
4
5
6
7
8
9
10
[root@redis-sentinel1 /]# docker exec -it redis-sentinel1 bash
root@6409bc6f6ce5:/data# redis-cli -p 6667 info Sentinel
# Sentinel
sentinel_masters:1
sentinel_tilt:0
sentinel_tilt_since_seconds:-1
sentinel_running_scripts:0
sentinel_scripts_queue_length:0
sentinel_simulate_failure_flags:0
master0:name=mymaster,status=ok,address=172.19.0.101:6666,slaves=2,sentinels=1

5.模拟主节点故障

停止主节点

1
docker stop redis-master

查看哨兵节点信息 此时主节点变成了 172.19.0.102 原来的 slave1

1
2
3
4
5
6
7
8
9
10
[root@redis-sentinel1 /]# docker exec -it redis-sentinel1 bash
root@b69b7fc37a49:/data# redis-cli -p 6667 info Sentinel
# Sentinel
sentinel_masters:1
sentinel_tilt:0
sentinel_tilt_since_seconds:-1
sentinel_running_scripts:0
sentinel_scripts_queue_length:0
sentinel_simulate_failure_flags:0
master0:name=mymaster,status=ok,address=172.19.0.102:7777,slaves=2,sentinels=3

查看其他两个从节点信息 此时之前的 slave1 的角色变成了 master

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
# slave1
[root@redis-slave1 /]# docker exec -it redis-slave1 redis-cli -p 7777 -a 123456 info replication
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
# Replication
role:master
connected_slaves:1
slave0:ip=172.19.0.103,port=8888,state=online,offset=180670,lag=1
master_failover_state:no-failover
master_replid:8a814c929ed52b786c36b5d1e07ebad1b907a7dc
master_replid2:e7107664d2c67a733e3f6901252ba88823eb51e6
master_repl_offset:180670
second_repl_offset:172840
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:15
repl_backlog_histlen:180656

slave1 的角色 未变,主节点变成了 172.19.0.102

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
# slave2
[root@node2 /]# docker exec -it redis-slave2 redis-cli -p 8888 -a 123456 info replication
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
# Replication
role:slave
master_host:172.19.0.102
master_port:7777
master_link_status:up
master_last_io_seconds_ago:1
master_sync_in_progress:0
slave_read_repl_offset:184084
slave_repl_offset:184084
slave_priority:100
slave_read_only:1
replica_announced:1
connected_slaves:0
master_failover_state:no-failover
master_replid:8a814c929ed52b786c36b5d1e07ebad1b907a7dc
master_replid2:e7107664d2c67a733e3f6901252ba88823eb51e6
master_repl_offset:184084
second_repl_offset:172840
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:29
repl_backlog_histlen:184056

重新启动 redis-master

1
docker start redis-master

查看redis-master的节点信息 原来的主节点变成了从节点

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
[root@redis-master /]# docker exec -it redis-master redis-cli -p 6666 -a 123456 info replication
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
# Replication
role:slave
master_host:172.19.0.102
master_port:7777
master_link_status:down
master_last_io_seconds_ago:-1
master_sync_in_progress:0
slave_read_repl_offset:184150
slave_repl_offset:184150
master_link_down_since_seconds:-1
slave_priority:100
slave_read_only:1
replica_announced:1
connected_slaves:0
master_failover_state:no-failover
master_replid:14a30a8a3b44d169f4dc071a059ab38be7b4759a
master_replid2:e7107664d2c67a733e3f6901252ba88823eb51e6
master_repl_offset:184150
second_repl_offset:172840
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:172840
repl_backlog_histlen:11311

四、redis集群部署

1.创建容器实例

创建6个docker容器实例

1
2
3
4
5
6
7
8
9
10
11
docker run -d --name redis-node-1 --net host --privileged=true -v /data/redis/cluster1/data:/data redis:7.0.0 --cluster-enabled yes --appendonly yes --port 6381
docker run -d --name redis-node-2 --net host --privileged=true -v /data/redis/cluster2/data:/data redis:7.0.0 --cluster-enabled yes --appendonly yes --port 6382
docker run -d --name redis-node-3 --net host --privileged=true -v /data/redis/cluster3/data:/data redis:7.0.0 --cluster-enabled yes --appendonly yes --port 6383
docker run -d --name redis-node-4 --net host --privileged=true -v /data/redis/cluster4/data:/data redis:7.0.0 --cluster-enabled yes --appendonly yes --port 6384
docker run -d --name redis-node-5 --net host --privileged=true -v /data/redis/cluster5/data:/data redis:7.0.0 --cluster-enabled yes --appendonly yes --port 6385
docker run -d --name redis-node-6 --net host --privileged=true -v /data/redis/cluster6/data:/data redis:7.0.0 --cluster-enabled yes --appendonly yes --port 6386

--net host : 使用宿主机deIP和端口,默认
--privileged=true :容器卷,宿主机地址:docker内部地址
--cluster-enabled yes : 开启redis集群
--appendonly yes : 开启持久化

此时用docker exec -it redis-node-1 redis-cli -p 6381 info replication查看每个节点信息,所有节点都是普通的redis节点

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
# 此处用 redis-node-1 redis-node-4 示例
[root@RedisCluster ~]# docker exec -it redis-node-1 redis-cli -p 6381 info replication
# Replication
role:master
connected_slaves:0
master_failover_state:no-failover
master_replid:bec614547c3678f29215c6d141954400fb23cb4d
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:0
second_repl_offset:-1
repl_backlog_active:0
repl_backlog_size:1048576
repl_backlog_first_byte_offset:0
repl_backlog_histlen:0

[root@RedisCluster ~]# docker exec -it redis-node-4 redis-cli -p 6384 info replication
# Replication
role:master
connected_slaves:0
master_failover_state:no-failover
master_replid:9c05447fce753e2820b78d68c2bdbf05b13fcd94
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:0
second_repl_offset:-1
repl_backlog_active:0
repl_backlog_size:1048576
repl_backlog_first_byte_offset:0
repl_backlog_histlen:0

2.构建集群关系

在任意一台redis容器,为6台机器构建集群关系

1
2
3
docker exec -it redis-node-1 redis-cli --cluster create 192.168.8.89:6381 192.168.8.89:6382 192.168.8.89:6383 192.168.8.89:6384 192.168.8.89:6385 192.168.8.89:6386 --cluster-replicas 1

--cluster-replicas 1 : 表示为每个master创建一个slave节点

此时用docker exec -it redis-node-1 redis-cli -p 6381 info replication查看每个节点信息,其中三台成为了主节点,各有一个从节点,另外三个成为了从节点,分别与三个主节点对应

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
# 再看 redis-node-1 redis-node-4
[root@RedisCluster ~]# docker exec -it redis-node-1 redis-cli -p 6381 info replication
# Replication
role:master
connected_slaves:1 # 有了一个从节点
slave0:ip=192.168.8.89,port=6384,state=online,offset=56,lag=0 # 从节点为 redis-node-4
master_failover_state:no-failover
master_replid:0fd96b71a984b7fc49ce3db85ada2f5278f343c0
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:56
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:56

[root@RedisCluster ~]# docker exec -it redis-node-4 redis-cli -p 6384 info replication
# Replication
role:slave # 成为了从节点
master_host:192.168.1.89 # 主节点为 redis-node-1
master_port:6381
master_link_status:up
master_last_io_seconds_ago:5
master_sync_in_progress:0
slave_read_repl_offset:84
slave_repl_offset:84
slave_priority:100
slave_read_only:1
replica_announced:1
connected_slaves:0
master_failover_state:no-failover
master_replid:0fd96b71a984b7fc49ce3db85ada2f5278f343c0
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:84
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:84

3.查看集群状态

在 redis-node-1 节点 查看集群状态

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
[root@RedisCluster ~]# docker exec -it redis-node-1 redis-cli -p 6381 cluster info
cluster_state:ok # 集群状态正常,没有发现问题。
cluster_slots_assigned:16384 # 集群中总共分配的槽位数量,Redis 集群有 16384 个槽位用于数据分片。
cluster_slots_ok:16384 # 当前所有分配的槽位都处于正常状态。
cluster_slots_pfail:0 # 处于部分故障状态的槽位数量,即有节点部分不可用但未完全失败。
cluster_slots_fail:0 # 完全故障的槽位数量,即存在故障的槽位无法访问。
cluster_known_nodes:6 # 当前集群中已知的节点总数。
cluster_size:3 # 集群中实际的主节点数量,说明集群由 3 个主节点组成。
cluster_current_epoch:6 # 当前的集群周期(epoch),用于跟踪集群配置变更的版本。
cluster_my_epoch:1 # 当前节点的 epoch 版本,表明该节点的配置周期。
cluster_stats_messages_ping_sent:896 # 当前节点发送的 PING 消息数量,用于检查节点状态。
cluster_stats_messages_pong_sent:908 # 当前节点发送的 PONG 消息数量,响应 PING 消息。
cluster_stats_messages_sent:1804 # 当前节点总共发送的集群消息数量。
cluster_stats_messages_ping_received:903 # 当前节点接收到的 PING 消息数量。
cluster_stats_messages_pong_received:896 # 当前节点接收到的 PONG 消息数量。
cluster_stats_messages_meet_received:5 # 当前节点接收到的 MEET 消息数量,用于节点加入集群时的通知。
cluster_stats_messages_received:1804 # 当前节点接收到的总集群消息数量。
total_cluster_links_buffer_limit_exceeded:0 # 总的超出集群链接缓冲区限制的情况次数,即没有网络缓冲区溢出的情况。

[root@RedisCluster ~]# docker exec -it redis-node-1 redis-cli -p 6381 cluster nodes
e60b10ab474e0f5486a81a4cbedff8ebdceb30d6 192.168.8.89:6383@16383 master - 0 1724982408000 3 connected 10923-16383 # redis-node-3 该节点负责槽位10923-16383
12b6cf941b53841c5ff87c40ca6bf40a1faffd3c 192.168.8.89:6384@16384 slave 4907c84ab99f8a6ec66ae9e4dbd4eba7e6f0175b 0 1724982408048 1 connected
f7525d3c24d723a4ec54c3f382f65ef3bea36659 192.168.8.89:6382@16382 master - 0 1724982410056 2 connected 5461-10922 # redis-node-2 该节点负责槽位5461-10922
4907c84ab99f8a6ec66ae9e4dbd4eba7e6f0175b 192.168.8.89:6381@16381 myself,master - 0 1724982408000 1 connected 0-5460 # redis-node-1 该节点负责槽位0-5460
c3ab49b00116b0bd8eda65a1a16125281df62f25 192.168.8.89:6385@16385 slave f7525d3c24d723a4ec54c3f382f65ef3bea36659 0 1724982407044 2 connected
92a667a6d591a297304cc8fef6c4ad6f8edca8ec 192.168.8.89:6386@16386 slave e60b10ab474e0f5486a81a4cbedff8ebdceb30d6 0 1724982409052 3 connected


4.数据读写

redis集群读取数据需要以 redis-cli -p 6381 -c 集群的方式连接,否则会添加数据时会出现 (error) MOVED 12706 192.168.8.89:6382

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
[root@node2 ~]# docker exec -it redis-node-1 bash
root@node2:/data# redis-cli -p 6381 -c
127.0.0.1:6381> set k1 v1
-> Redirected to slot [12706] located at 192.168.8.89:6383
OK
192.168.8.89:6383> set k2 v2
-> Redirected to slot [449] located at 192.168.8.89:6381
OK
192.168.8.89:6381> set k3 v3
OK
192.168.8.89:6381>
192.168.8.89:6381> set k4 v4
-> Redirected to slot [8455] located at 192.168.8.89:6382
OK
192.168.8.89:6382>
192.168.8.89:6382> keys *
1) "k4"

Redis 集群使用分片(sharding)机制将数据分布在多个节点上,每个节点只存储一部分数据。因此,不同节点的数据是不同的。集群中的主节点负责处理写操作,并将数据分片分配给从节点进行复制和备份。

1
2
3
4
5
# 此处以下面的操作为例
127.0.0.1:6381> set k1 v1
-> Redirected to slot [12706] located at 192.168.8.89:6383
OK
# 当前在 redis-node-1 操作,将键 k1 设置为值 v1,由于 Redis 集群的分片机制,键 k1 被映射到集群中的槽位 12706。当前的节点 127.0.0.1:6381 并不是该槽位的主节点,因此该操作被重定向到负责槽位 12706 的节点,即 192.168.8.89:6383

查看redis-node-2中所有key值

1
2
192.168.8.89:6382> keys *
1) "k4"

5.故障模拟

5.1 关闭 redis-node-1 节点,通过redis-node-2查看集群信息

1
2
3
4
5
6
7
8
9
10
11
12
[root@node2 ~]# docker stop redis-node-1
redis-node-1
[root@node2 ~]# docker exec -it redis-node-2 redis-cli -p 6382 cluster nodes
e60b10ab474e0f5486a81a4cbedff8ebdceb30d6 192.168.8.89:6383@16383 master - 0 1724990223934 3 connected 10923-16383
4907c84ab99f8a6ec66ae9e4dbd4eba7e6f0175b 192.168.8.89:6381@16381 master,fail - 1724990202776 1724990200000 1 disconnected
c3ab49b00116b0bd8eda65a1a16125281df62f25 192.168.8.89:6385@16385 slave f7525d3c24d723a4ec54c3f382f65ef3bea36659 0 1724990223000 2 connected
f7525d3c24d723a4ec54c3f382f65ef3bea36659 192.168.8.89:6382@16382 myself,master - 0 1724990224000 2 connected 5461-10922
92a667a6d591a297304cc8fef6c4ad6f8edca8ec 192.168.8.89:6386@16386 slave e60b10ab474e0f5486a81a4cbedff8ebdceb30d6 0 1724990225944 3 connected
12b6cf941b53841c5ff87c40ca6bf40a1faffd3c 192.168.8.89:6384@16384 master - 0 1724990224939 7 connected 0-5460

此时 192.168.8.89:6381@16381 master,fail redis-node-1 节点 fail
原来的 redis-node-4 上位,由原来的slave成为了master

结论:master 宕机,slave会自动上位变成master

5.2 重新启动 redis-node-1

1
2
3
4
5
6
7
8
9
10
[root@node2 ~]# docker start redis-node-1
redis-node-1
[root@node2 ~]# docker exec -it redis-node-2 redis-cli -p 6382 cluster nodes
e60b10ab474e0f5486a81a4cbedff8ebdceb30d6 192.168.8.89:6383@16383 master - 0 1724994223167 3 connected 10923-16383
4907c84ab99f8a6ec66ae9e4dbd4eba7e6f0175b 192.168.8.89:6381@16381 slave 12b6cf941b53841c5ff87c40ca6bf40a1faffd3c 0 1724994222995 7 connected
c3ab49b00116b0bd8eda65a1a16125281df62f25 192.168.8.89:6385@16385 slave f7525d3c24d723a4ec54c3f382f65ef3bea36659 0 1724994222000 2 connected
f7525d3c24d723a4ec54c3f382f65ef3bea36659 192.168.8.89:6382@16382 myself,master - 0 1724994222000 2 connected 5461-10922
92a667a6d591a297304cc8fef6c4ad6f8edca8ec 192.168.8.89:6386@16386 slave e60b10ab474e0f5486a81a4cbedff8ebdceb30d6 0 1724994224171 3 connected
12b6cf941b53841c5ff87c40ca6bf40a1faffd3c 192.168.8.89:6384@16384 master - 0 1724994222089 7 connected 0-5460
此时 redis-node-4 上位,还是master,redis-node-1为slave

结论: 即使之前宕机的Master 重新启动,加入集群之后也是slave。

6.主从扩容

6.1 新增机器 6387 6388

1
2
docker run -d --name redis-node-7 --net host --privileged=true -v /data/redis/cluster7/data:/data redis:7.0.0 --cluster-enabled yes --appendonly yes --port 6387
docker run -d --name redis-node-8 --net host --privileged=true -v /data/redis/cluster8/data:/data redis:7.0.0 --cluster-enabled yes --appendonly yes --port 6388

6.2 将6387节点(空槽号)作为master节点加入原集群

1
docker exec -it redis-node-7 redis-cli --cluster add-node 192.168.8.89:6387 192.168.8.89:6381

6.3 第一次检查集群情况

1
docker exec -it redis-node-1 redis-cli --cluster check 192.168.8.89:6381

6.4 重新分配槽号

1
docker exec -it redis-node-1 redis-cli --cluster reshard 192.168.8.89:6381

image-20240830144621474

6.5 第二次检查集群情况

1
docker exec -it redis-node-1 redis-cli --cluster check 192.168.8.89:6381

image-20240830144651686

6.6 为6387主节点分配6388从节点

1
2
3
4
docker exec -it redis-node-7 redis-cli --cluster add-node 192.168.8.89:6388 192.168.8.89:6387 --cluster-slave --cluster-master-id 00633b62dd8f9e6ba5d03dc8c963667f63e57975

redis-cli --cluster add-node ip:新slave端口 ip:新master端口 --cluster-slave --cluster-master-id slave的编号

image-20240830145037423

6.7 第三次检查集群情况

1
docker exec -it redis-node-1 redis-cli --cluster check 192.168.8.89:6381

image-20240830145205200

7.主从缩容

7.1 删除6388节点

1
docker exec -it redis-node-1 redis-cli --cluster del-node 192.168.8.89:6388 fd91a8aeadac79fe892007c32ab23b8ed41c0846

7.2 对集群重新分配槽位

删除6387节点前需要先将分配给其的槽位全部分配置去,否则删除会报错,因此先重新分配槽位

1
docker exec -it redis-node-1 redis-cli --cluster reshard 192.168.8.89:6381

image-20240830164056984

在此处将 redis-node-7 的4096个槽位全部分给了 redis-node-1

7.3 删除6387节点

1
docker exec -it redis-node-1 redis-cli --cluster del-node 192.168.8.89:6387 00633b62dd8f9e6ba5d03dc8c963667f63e57975

image-20240830164254493

7.4 检查集群情况

1
docker exec -it redis-node-1 redis-cli --cluster check 192.168.8.89:6381

image-20240830164304856

此时 redis-node-7 redis-node-8 两个节点都已经删除

mysql备份数据库
mysql备份单个数据库

1
2
3
4
5
#mysql备份某个库格式:
mysqldump -h主机名 -P端口 -u用户名 -p"密码" --database 数据库名 > 文件名.sql

#实例:mysql备份某个库:
mysqldump -h10.*.*.9 -P3306 -uroot -p"密码" --single-transaction --master-data=2 --set-gtid-purged=OFF --database -B db_mystorage > mysqldump_db_mystorage_`date +%Y%m%d-%H%M`.sql

mysql备份多个数据库

1
2
3
4
5
#mysql备份某个库格式:
mysqldump -h主机名 -P端口 -u用户名 -p"密码" --database 数据库名1 数据库名2 数据库名3 > 文件名.sql

#实例:mysql备份某个库:
mysqldump -h10.*.*.9 -P3306 -uroot -p"密码" --single-transaction --master-data=2 --set-gtid-purged=OFF --database -B db_mystorage db_myblogs db_myOA > mysqldump_db_mystorage_db_myblogs_db_myOA_`date +%Y%m%d-%H%M`.sql

mysql备份所有的库

1
2
3
4
5
#mysql备份所有的库格式:
mysqldump -h主机名 -P端口 -u用户名 -p"密码" --all-databases > 文件名.sql

#实例:mysql备份所有的库:
mysqldump -h10.*.*.9 -P3306 -u用户名 -p"密码" --single-transaction --master-data=2 --set-gtid-purged=OFF --all-databases > mysqldump_all_databases_`date +%Y%m%d-%H%M`.sql

注意:如上命令 -A 或者 –all-databases 是备份该用户名拥有的全部数据库。

mysql备份特定表

1
2
3
4
5
#mysql备份某个库格式:
mysqldump -h主机名 -P端口 -u用户名 -p"密码" 数据库名 表名 > 文件名.sql

#实例:备份db_plus_core库中的tb_doc_permission表
mysqldump -h10.*.*.9 -P3306 -uroot -p"密码" --single-transaction --master-data=2 --set-gtid-purged=OFF db_plus_core tb_doc_permission > mysqldump_tb_doc_permission_`date +%Y%m%d-%H%M`.sql

mysql备份特定多个表

1
2
3
4
5
#mysql备份某个库格式:
mysqldump -h主机名 -P端口 -u用户名 -p"密码" 数据库名 表名1 表名2 > 文件名.sql

#实例:备份db_plus_core库中的tb_doc_permission表
mysqldump -h10.*.*.9 -P3306 -uroot -p"密码" --single-transaction --master-data=2 --set-gtid-purged=OFF db_plus_core tb_1 tb_2 > mysqldump_tb_1_tb_2_`date +%Y%m%d-%H%M`.sql

备份命令的 -B 参数
执行备份语句的时候,其中可以加上很多的参数,用来添加一些备份的时候的特殊要求的,其中有一个-B参数。执行备份语句时,如果加上了-B参数,那么将来再执行数据还原的时候,就不需要自己到数据库里面去先创建一个目标库了,并且执行数据还原语句的时候也不需要指定目标库了。如果没有加-B参数,就需要自行到数据库中先创建一个目标库,并且执行恢复语句时要指定将数据恢复到目标库。

原因是-B参数导出的文件中自带创建数据库和连接数据库的功能:(使用-B参数备份出来的内容自带create database 库名和use 库名的功能)。

备份命令的 | gzip 管道符
【压缩备份】:实际生产上导出的数据有可能比较大,不好备份到远程,这时候就需要进行压缩。
mysql压缩备份:

1
2
3
4
5
6
7
8
9
10
11
#mysql压缩备份格式:
mysqldump -h主机名 -P端口 -u用户名 -p"密码" --database 数据库名 | gzip > 文件名.sql.gz

#实例一:mysql压缩备份
mysqldump -h10.*.*.9 -P3306 -uroot -p"密码" --single-transaction --master-data=2 --set-gtid-purged=OFF --database db_plus_core | gzip > mysqldump_db_plus_core_`date +%Y%m%d-%H%M`.sql.gz

#实例二:mysql压缩备份全部数据库:
mysqldump -h10.*.*.9 -P3306 -uroot -p"密码" --single-transaction --master-data=2 --all-databases | gzip > mysqldump_alldatabases_`%Y%m%d-%H%M`.sql.gz

#实例三:如果mysql开了GTID模式就要用这个命令
mysqldump -h10.*.*.9 -P3306 -uroot -p"密码" --single-transaction --master-data=2 --set-gtid-purged=OFF --all-databases | gzip > mysqldump_alldatabases_`%Y%m%d-%H%M`.sql.gz

mysql备份数据带出删除数据库或者表的sql备份
备份时,可以带出删除库的参数–add-drop-database,带出删除表的参数–add-drop-table

1
2
3
4
#格式:
mysqldump -h主机名 -P端口 -u用户名 -p"密码" --add-drop-table --add-drop-database 数据库名 > 文件名.sql
#示例:
mysqldump -h10.*.*.9 -P3306 -uroot -p"密码" --add-drop-table --add-drop-database cmdb > /data/backup/mysqldump_cmdb_`%Y%m%d-%H%M`.sql

仅备份数据库结构,不包含数据
有时候我们仅仅只想备份出环境,数据库/表/字段结构,可以加命令参数–no-data

1
2
3
4
#格式:
mysqldump -h主机名 -P端口 -u用户名 -p"密码" --no-data 数据库名1 数据库名2 > 文件名.sql
#示例:
mysqldump -h10.*.*.9 -P3306 -uroot -p"密码" --no-data db1 db2 > /data/backup/mysqldump_no_data_db1_db2_`%Y%m%d-%H%M`.sql

mysqldump恢复数据备份

1
2
3
4
5
6
7
8
#格式:
mysqldump -h主机名 -P端口 -u用户名 -p"密码" --no-data 数据库名1 数据库名2 > 文件名.sql

#示例:还原db_plus_core库中的tb_doc_permission表的备份
mysqldump -uroot -p"密码" db_plus_core < mysqldump_20180114_tb_doc_permission.sql

#示例:还原所有的库(保底操作,按需执行)
mysqldump -uroot -p"密码" < mysqldump_20240114_all_databases.sql

通过mysql默认的终端执行恢复命令
【通过source命令恢复数据库】
进入mysql数据库控制台,mysql -uroot -p3306登陆后
    mysql>use 数据库;
    然后使用source命令,后面参数为脚本文件(如这里用到的是.sql文件,如果你备份的是.txt文件,那这里写.txt文件)

    mysql>source crm2.sql #这个文件是系统路径下的,默认是登陆mysql前的系统路径,在mysql中查看系统路径的方法是通过system+系统命令来搞的
    mysql>system ls

【利用mysql命名恢复(标准)】
如下:

1
2
3
mysql -root -p3306 -e "use crm2;drop table student;show tables;" 必须是双引号
mysql -uroot -p3306 crm2<f:\数据库备份练习\crm2.sql
mysql -uroot -p3306 -e "use crm2;show tables;"

注:如果sql文件里面没有use db这样的字样时,在导入时就要指定数据库名了。

1
mysql -uroot -p3306 crm2<.sql文件

建议备份数据库时都指定上-B参数,效果好。
说明:mysql不光可以恢复mysqldump的备份,只要文件中是sql语句,都可以通过mysql命令执行到数据库中
mysql 带 -e 参数实现非交互式对话,就是不需要到mysql里面去,在外面执行里面的指令的方法,

例如:mysql -uroot -p3306 -e “use crm2;show tables;”,但是语句必须是双引号包裹。
详情参考链接:https://www.cnblogs.com/yanghongtao/p/10897282.html

Mysql备份表及部分数据
有时候我们只需要备份某个表里面的部分数据,快速恢复关键业务。
【原理】:使用 like 命令快速复制一个表(结构一模一样),将要备份的部分数据查询出来备份到新表里面,使用完了以后再恢复回去。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
#示例:
mysql -h10.*.*.9 -P3306 -uroot -p"密码"
use db_mystorage;
#step1:拷贝一份新的表结构
create table tb_staff_bak like tb_staff;
#step2:将要备份的部分数据查询出来备份到新表里面
insert into tb_staff_bk select * from tb_staff where name in ('xiong','zhang');
#step3:清理目标数据
delete from tb_staff where name in ('xiong','zhang');

#回滚与恢复:
insert into tb_staff select * from tb_staff_bk;

drop table tb_staff_bk;

实例:mysql自动备份脚本
备份方式:通过mysqldump的方式备份数据库,并保留7天备份数据。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
#!/bin/bash
backupdir=/data/mysqlbak #备份文件存放路径
time=`date +%Y%m%d-%H%M` #备份文件名称时间标记

mysqldump -h10.*.*.9 -P3306 -uroot -p"密码" --all-databases --single-transaction --default-character-set=utf8 |gzip > $backupdir/mysql$time.sql.gz #备份所有数据库并打包

find $backupdir -name "mysql*.sql.gz" -type f -mtime +7 -exec rm {} \; > /dev/null 2>&1 #删除7天之外的备份文件
创建备份目录
mkdir -pv /data/mysqlbak

给备份脚本授权
chmod +x /data/mysqlbak/mysqlbak.sh

添加计划任务
crontab -e
00 3 * * * /data/mysqlbak/bakmysql.sh

【恢复使用】
解压
gzip -d mysql2020703.sql.gz

非压缩备份文件恢复:
mysql -u用户名 -p < mysql2020703.sql

从压缩文件直接恢复:
gzip < mysql22020703.sql.gz | mysql -u 用户名 -p

DockerCompose多应用布署

一、安装dockercompose

1、下载
1
curl -L https://github.com/docker/compose/releases/download/1.21.1/docker-compose-`uname -s`-`uname -m` -o /usr/local/bin/docker-compose
2、赋权
1
chmod +x /usr/local/bin/docker-compose
3、查看版本
1
docker-compose --version
4、卸载
1
rm docker-compose

二、配置docker-compose.yml

docker-compose 同目录创建 docker-compose.yml,也可以创建在其他目录,启动时使用-f参数指定文件路径

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
services:
rocketmq-namesrv-1:
image: apache/rocketmq:4.9.1
container_name: rocketmq-namesrv-1
ports:
\- 9876:9876
volumes:
\- /etc/localtime:/etc/localtime:ro
\- /data/middleware/rocketmq/logs/nameserver1:/home/rocketmq/logs/rocketmqlogs
command: sh mqnamesrv
networks:
\- rocketmq
rocketmq-namesrv-2:
image: apache/rocketmq:4.9.1
container_name: rocketmq-namesrv-2
ports:
\- 9877:9876
volumes:
\- /etc/localtime:/etc/localtime:ro
\- /data/middleware/rocketmq/logs/nameserver2:/home/rocketmq/logs/rocketmqlogs
command: sh mqnamesrv
networks:
\- rocketmq

rocketmq-broker-1:
image: apache/rocketmq:4.9.1
container_name: rocketmq-broker-1
ports:
\- 10911:10911
volumes:
\- /etc/localtime:/etc/localtime:ro
\- /data/middleware/rocketmq/logs/broker1:/home/rocketmq/logs/rocketmqlogs
\- /data/middleware/rocketmq/data/store1:/home/rocketmq/store
\- /data/middleware/rocketmq/conf/broker1/broker.conf:/home/rocketmq/rocketmq-4.9.1/conf/broker.conf
environment:
TZ: Asia/Shanghai
NAMESRV_ADDR: "rocketmq-namesrv-1:9876;rocketmq-namesrv-2:9876"
JAVA_OPTS: "-Duser.home=/opt"
JAVA_OPT_EXT: "-server -Xms128m -Xmx128m -Xmn128m"
command: sh mqbroker -c /home/rocketmq/rocketmq-4.9.1/conf/broker.conf autoCreateTopicEnable=true &
depends_on:
\- rocketmq-namesrv-1
\- rocketmq-namesrv-2
networks:
\- rocketmq

rocketmq-broker-2:
image: apache/rocketmq:4.9.1
container_name: rocketmq-broker-2
ports:
\- 10912:10911
volumes:
\- /etc/localtime:/etc/localtime:ro
\- /data/middleware/rocketmq/logs/broker2:/home/rocketmq/logs/rocketmqlogs
\- /data/middleware/rocketmq/data/store2:/home/rocketmq/store
\- /data/middleware/rocketmq/conf/broker2/broker.conf:/home/rocketmq/rocketmq-4.9.1/conf/broker.conf
environment:
TZ: Asia/Shanghai
NAMESRV_ADDR: "rocketmq-namesrv-1:9876;rocketmq-namesrv-2:9876"
JAVA_OPTS: " -Duser.home=/opt"
JAVA_OPT_EXT: "-server -Xms128m -Xmx128m -Xmn128m"
command: sh mqbroker -c /home/rocketmq/rocketmq-4.9.1/conf/broker.conf autoCreateTopicEnable=true &
depends_on:
\- rocketmq-namesrv-1
\- rocketmq-namesrv-2
networks:
\- rocketmq

rocketmq-broker-3:
image: apache/rocketmq:4.9.1
container_name: rocketmq-broker-3
ports:
\- 10913:10911
volumes:
\- /etc/localtime:/etc/localtime:ro
\- /data/middleware/rocketmq/logs/broker3:/home/rocketmq/logs/rocketmqlogs
\- /data/middleware/rocketmq/data/store3:/home/rocketmq/store
\- /data/middleware/rocketmq/conf/broker3/broker.conf:/home/rocketmq/rocketmq-4.9.1/conf/broker.conf
environment:
TZ: Asia/Shanghai
NAMESRV_ADDR: "rocketmq-namesrv-1:9876;rocketmq-namesrv-2:9876"
JAVA_OPTS: " -Duser.home=/opt"
JAVA_OPT_EXT: "-server -Xms128m -Xmx128m -Xmn128m"
command: sh mqbroker -c /home/rocketmq/rocketmq-4.9.1/conf/broker.conf autoCreateTopicEnable=true &
depends_on:
\- rocketmq-namesrv-1
\- rocketmq-namesrv-2
networks:
\- rocketmq

rocketmq-console:
image: styletang/rocketmq-console-ng:1.0.0
container_name: rocketmq-console
ports:
\- 9090:8080
volumes:
\- /etc/localtime:/etc/localtime:ro
\- /data/middleware/rocketmq/logs/console:/root/logs
environment:
JAVA_OPTS: -Drocketmq.namesrv.addr=rocketmq-namesrv-1:9876;rocketmq-namesrv-2:9876 -Dcom.rocketmq.sendMessageWithVIPChannel=false
networks:
\- rocketmq
depends_on:
\- rocketmq-broker-1
\- rocketmq-broker-2
\- rocketmq-broker-3

networks:
rocketmq:
driver: bridge

其中broker配置store的时候,宿主机/data/middleware/rocketmq/data/下的store需要赋权,使docker可以写数据,否则broker无法启动

三、配置broker.conf

三个broker都需要配置,注意brokerName各不相同

1
2
3
4
5
6
7
8
9
rokerClusterName = DefaultCluster
brokerName = rocketmq-broker-1
brokerId = 0
deleteWhen = 04
fileReservedTime = 48
brokerRole = ASYNC_MASTER
flushDiskType = ASYNC_FLUSH
brokerIP1=192.168.1.170
storePathRootDir=/home/rocketmq/store

四、docker-compose常用命令

启动服务

1
2
3
# -f 指定配置文件 文件名是docker-compose.yml且与docker-compose同目录时可以不指定,直接docker-compose up -d 启动

docker-compose -f docker-compose.yml up -d

重新启动指定服务

1
docker-compose up -d 【服务名】

重启全部服务

1
docker-compose restart

自动关闭并删除容器

1
docker-compose down

加参数 -v 同时删除卷

1
docker-compose down -v

DockerCompose多应用布署

一、安装dockercompose

1、下载

1
curl -L https://github.com/docker/compose/releases/download/1.21.1/docker-compose-`uname -s`-`uname -m` -o /usr/local/bin/docker-compose

2、赋权

1
chmod +x /usr/local/bin/docker-compose

3、查看版本

1
docker-compose --version

4、卸载

1
rm docker-compose

二、配置yml文件

docker-compose 同目录创建 docker-compose.yml

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
networks:
nginx_network:
driver: bridge
redis_network:
driver: bridge
nacos_network:
driver: bridge
mysql_network:
driver: bridge
minio_network:
driver: bridge
services:
redis:
image: redis:6.0.8
container_name: redis
networks:
- redis_network
volumes:
- /data/middleware/redis/data:/data:/data # 以数据卷挂载给reids数据备份
ports:
- "6379:6379"
restart: always
nginx:
image: nginx:1.21.4
container_name: nginx
ports:
- "80:80"
volumes:
- /data/middleware/nginx/nginx.conf:/etc/nginx/nginx.conf
- /data/middleware/nginx/default.conf:/etc/nginx/conf.d/default.conf
- /data/middleware/nginx/web:/usr/share/nginx/html/
- /data/middleware/nginx/logs:/var/log/nginx # 挂载日志
networks:
- nginx_network
restart: always
mysql :
image: mysql:5.7
container_name: mysql
ports:
- "3306:3306"
volumes:
- /data/middleware/mysql/data:/var/lib/mysql
environment:
- MYSQL_ROOT_PASSWORD=Abc123..!
- MYSQL_LOG_CONSOLE=true
networks:
- mysql_network
restart: always
nacos :
image: nacos/nacos-server
container_name: nacos
ports:
- "8848:8848"
- "9848:9848"
- "9849:9849"
volumes:
- /data/middleware/nacos/logs:/home/nacos/logs
- /data/middleware/nacos/data:/home/nacos/data
networks:
- nacos_network
restart: always
environment:
MODE: standalone
JVM_XMS: 512m
JVM_XMX: 512m
JVM_MS: 64m
JVM_MMS: 64m
NACOS_AUTH_ENABLE: 'true'
NACOS_SERVER_PORT: '8848'
PREFER_HOST_MODE: hostname
NACOS_SERVER_IP: 127.0.0.1
minio:
image: minio/minio:RELEASE.2021-04-22T15-44-28Z
container_name: minio
ports:
- "9000:9000"
volumes:
- /data/middleware/minio/data:/data
environment:
MINIO_ACCESS_KEY: admin
MINIO_SECRET_KEY: Abc123..!
networks:
- minio_network
command: server /data

三、常用命令

启动服务

1
docker-compose -f docker-compose.yml up -d   # -f 指定配置文件

重新启动指定服务

1
docker-compose up -d 【服务名】

重启全部服务

1
docker-compose restart

自动关闭并删除容器

1
docker-compose down

加参数 -v 同时删除卷

1
docker-compose down -v

etcd 镜像下载

1
docker pull quay.io/coreos/etcd:v3.5.12

1、单节点 etcd 部署实战-基于配置文件

2.1 创建 etcd 数据目录

1
mkdir -p /data/containers/etcd/{data,config}
  • data 目录:建议, 存储容器持久化数据
  • config 目录:建议, 存储容器使用的配置文件

2.2 创建 etcd 配置文件

etcd 服务配置文件路径为:/data/containers/etcd/config/etcd.conf.yml

1
2
3
4
5
6
7
8
9
10
11
12
name: etcd-s1
data-dir: /var/etcd
listen-client-urls: http://0.0.0.0:2379
advertise-client-urls: http://0.0.0.0:2379
listen-peer-urls: http://0.0.0.0:2380
initial-advertise-peer-urls: http://0.0.0.0:2380
initial-cluster: etcd-s1=http://0.0.0.0:2380
initial-cluster-token: etcd-cluster
initial-cluster-state: new
logger: zap
log-level: info
#log-outputs: stderr

特殊参数说明:

name: etcd member 名称,可根据实际情况修改

data-dir: etcd 数据目录,可根据实际情况修改

listen-client-urls: client 流量监听地址,没特殊需求按文档填写即可

advertise-client-urls: 该 member 向外部通告的客户端 url 列表,单节点部署时不需要修改,集群部署模式需修改为容器所在节点对外提供服务的 IP

listen-peer-urls: peer 流量监听地址,没特殊需求按文档填写即可

initial-advertise-peer-urls: 该 member 向同一集群内其他 member 通告的 peer url 列表,单节点部署时不需要修改,集群部署模式需修改为容器所在节点对外提供服务的 IP

initial-cluster: 初始化集群节点信息,单节点部署时不需要修改,集群部署模式需要填写集群中所有 member 的信息

initial-cluster-token: 初始化集群时使用的 token,随便写

initial-cluster-state: 初始化集群状态,可选的值为 new 或者 existing,通常采用 new

2.3 创建 docker-compose 文件

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
version: '3'

services:
etcd:
container_name: etcd-s1
image: quay.io/coreos/etcd:v3.5.12
command: /usr/local/bin/etcd --config-file=/var/lib/etcd/conf/etcd.conf.yml
volumes:
- ${DOCKER_VOLUME_DIRECTORY:-.}/data:/var/etcd
- ${DOCKER_VOLUME_DIRECTORY:-.}/config/etcd.conf.yml:/var/lib/etcd/conf/etcd.conf.yml
- "/etc/localtime:/etc/localtime:ro"
ports:
- 2379:2379
- 2380:2380
restart: always

networks:
default:
name: etcd-tier
driver: bridge

2.4 创建并启动 etcd 服务

1
2
cd /data/containers/etcd
docker compose up -d

2.5 验证容器状态

  • 查看 etcd 容器状态
1
2
3
[root@docker-node-1 etcd]# docker compose ps -a
NAME IMAGE COMMAND SERVICE CREATED STATUS PORTS
etcd-s1 quay.io/coreos/etcd:v3.5.12 "/usr/local/bin/etcd…" etcd 53 seconds ago Up 53 seconds 0.0.0.0:2379-2380->2379-2380/tcp, :::2379-2380->2379-2380/tcp

3. 单节点 etcd 部署实战-基于环境变量

3.1 创建 etcd 数据目录

1
mkdir -p /data/containers/etcd/data
  • data 目录:建议, 存储容器持久化数据

3.2 创建 docker-compose 文件

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
version: '3'

services:
etcd:
container_name: etcd-s1
image: quay.io/coreos/etcd:v3.5.12
environment:
- ETCD_NAME=etcd-s1
- ETCD_DATA_DIR=/var/etcd
- ETCD_LISTEN_CLIENT_URLS=http://0.0.0.0:2379
- ETCD_ADVERTISE_CLIENT_URLS=http://0.0.0.0:2379
- ETCD_LISTEN_PEER_URLS=http://0.0.0.0:2380
- ETCD_INITIAL_ADVERTISE_PEER_URLS=http://0.0.0.0:2380
- ETCD_INITIAL_CLUSTER_TOKEN=etcd-cluster
- ETCD_INITIAL_CLUSTER=etcd-s1=http://0.0.0.0:2380
- ETCD_INITIAL_CLUSTER_STATE=new
- ETCD_LOGGER=zap
- ETCD_LOG_LeveL=info
volumes:
- ${DOCKER_VOLUME_DIRECTORY:-.}/data:/var/etcd
- "/etc/localtime:/etc/localtime:ro"
ports:
- 2379:2379
- 2380:2380
restart: always

networks:
default:
name: etcd-tier
driver: bridge

3.3 创建并启动 etcd 服务

1
2
cd /data/containers/etcd
docker compose up -d

3.4 验证容器状态

  • 查看 etcd 容器状态
1
2
3
[root@docker-node-1 etcd]# docker compose ps -a
NAME IMAGE COMMAND SERVICE CREATED STATUS PORTS
etcd-s1 quay.io/coreos/etcd:v3.5.12 "/usr/local/bin/etcd" etcd 17 seconds ago Up 16 seconds 0.0.0.0:2379-2380->2379-2380/tcp, :::2379-2380->2379-2380/tcp

4. etcd 服务可用性测试

为了测试 etcd 服务的可用性,额外再找一台机器安装 etcd 客户端工具用于验证测试。

  • 下载并解压软件包
1
2
3
4
cd /srv
wget https://github.com/etcd-io/etcd/releases/download/v3.5.12/etcd-v3.5.12-linux-amd64.tar.gz
tar xvf etcd-v3.5.12-linux-amd64.tar.gz
cd etcd-v3.5.12-linux-amd64

title: Docker部署MinIO
date: 2024-08-02
tags: docker

Docker部署MinIO

一、单节点部署

1、获取minio镜像
1
docker pull minio/minio:RELEASE.2021-04-22T15-44-28Z
2、启动
1
2
3
4
5
6
docker run -p 9000:9000 --name minio1 \
-d --restart=always \
-v /data/middleware/minio/data1:/data \
-e "MINIO_ACCESS_KEY=admin" \
-e "MINIO_SECRET_KEY=Abc@123.." \
minio/minio:RELEASE.2021-04-22T15-44-28Z server /data

二、集群部署(单服务器)

1、创建minio网络
1
docker network create --subnet=172.19.0.0/16 minio-net
2、启动四个节点
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
# minio1
docker run -id \
--name=minio1 \
--restart=always \
-p 9100:9000 \
-e "MINIO_ROOT_USER=minioadmin" \
-e "MINIO_ROOT_PASSWORD=minioadmin" \
-v /data/minios/minio1/data1:/data1 \
-v /data/minios/minio1/data2:/data2 \
--network minio-net --ip 172.19.0.2 \
minio/minio:RELEASE.2021-04-22T15-44-28Z server \
-address ":9000" \
http://172.19.0.{2...5}/data{1...2}
# minio2
docker run -id \
--name=minio2 \
--restart=always \
-p 9200:9000 \
-e "MINIO_ROOT_USER=minioadmin" \
-e "MINIO_ROOT_PASSWORD=minioadmin" \
-v /data/minios/minio2/data1:/data1 \
-v /data/minios/minio2/data2:/data2 \
--network minio-net --ip 172.19.0.3 \
minio/minio:RELEASE.2021-04-22T15-44-28Z server \
-address ":9000" \
http://172.19.0.{2...5}/data{1...2}
# minio3
docker run -id \
--name=minio3 \
--restart=always \
-p 9300:9000 \
-e "MINIO_ROOT_USER=minioadmin" \
-e "MINIO_ROOT_PASSWORD=minioadmin" \
-v /data/minios/minio3/data1:/data1 \
-v /data/minios/minio3/data2:/data2 \
--network minio-net --ip 172.19.0.4 \
minio/minio:RELEASE.2021-04-22T15-44-28Z server \
-address ":9000" \
http://172.19.0.{2...5}/data{1...2}
# minio4
docker run -id \
--name=minio4 \
--restart=always \
-p 9400:9000 \
-e "MINIO_ROOT_USER=minioadmin" \
-e "MINIO_ROOT_PASSWORD=minioadmin" \
-v /data/minios/minio4/data1:/data1 \
-v /data/minios/minio4/data2:/data2 \
--network minio-net --ip 172.19.0.5 \
minio/minio:RELEASE.2021-04-22T15-44-28Z server \
-address ":9000" \
http://172.19.0.{2...5}/data{1...2}

3、nginx配置

因为MinIO后台使用了WebSocket技术,需要在nginx上配置Upgrade、Connection等请求头来支持WebSocket的转发

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
upstream minioserver{
server 172.19.0.2:9000;
server 172.19.0.3:9000;
server 172.19.0.4:9000;
server 172.19.0.5:9000;
}

server {
listen 9000;
server_name localhost;
location / {
proxy_set_header Host $http_host;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
proxy_pass http://minioserver;
proxy_http_version 1.1;
proxy_set_header Upgrade $http_upgrade;
proxy_set_header Connection "upgrade";
}
}

启动nginx容器

1
2
3
4
5
6
7
8
docker run -d \
--name nginx \
-p 80:80 \
-p 9000:9000 \
-v /data/middleware/nginx/conf.d/:/etc/nginx/conf.d/ \
-v /etc/localtime:/etc/localtime \
--network minio-net --ip 172.19.0.6 \
nginx

注意!

1
2
在进行集群部署的时候一直出现各种报错,集群部署好了,nginx开始出错,最后发现是容器之间网络的问题,之后尝试创建一个minio-net网络,并给所有容器配置同一个网络,因为minio集群部署以及nginx转发需要指定IP,因此在配置的时候指定了IP,这些问题主要是在同一台服务器上部署minio集群的时候会出现。
在使用dockercompose部署的时候也需要注意容器之间的网络问题

Gitlab部署

一、前言

1、本文主要内容

  • GitLab社区版部署

  • GitLab配置禁用创建组权限

  • GitLab配置邮件(SMTP)

  • Gitlab备份配置

  • GitLab常用命令说明

    2、GitLab介绍

    GitLab一个开源的git仓库管理平台,方便团队协作开发、管理。在GitLab上可以实现完整的CI(持续集成)、CD(持续发布)流程。而且还提供了免费使用的Plan,以及免费的可以独立部署的社区版本(https://gitlab.com/gitlab-org/gitlab-ce )。官网:https://about.gitlab.com/

    二、准备工作

    1、安准基础依赖(这一步基本都可以跳过,很多服务器默认安装)

    1
    2
    3
    4
    5
    6
    #安装技术依赖
    sudo yum install -y curl policycoreutils-python openssh-server

    #启动ssh服务&设置为开机启动
    sudo systemctl enable sshd
    sudo systemctl start sshd

    2、安装Postfix

    Postfix是一个邮件服务器,GitLab发送邮件需要用到

    1
    2
    3
    4
    5
    6
    #安装postfix
    sudo yum install -y postfix

    #启动postfix并设置为开机启动
    sudo systemctl enable postfix
    sudo systemctl start postfix

    3、开放ssh以及http服务

    根据实际情况执行,公司内部服务器初始时,防火墙就没打开

    1
    2
    3
    4
    5
    6
    #开放ssh、http服务
    sudo firewall-cmd --add-service=ssh --permanent
    sudo firewall-cmd --add-service=http --permanent

    #重载防火墙规则
    sudo firewall-cmd --reload

    三、部署过程

    本次我们部署的是社区版:gitlab-ce,如果要部署商业版可以把关键字替换为:gitlab-ee

    1、Yum安装GitLab

  • 添加GitLab社区版Package

    1
    curl https://packages.gitlab.com/install/repositories/gitlab/gitlab-ce/script.rpm.sh | sudo bash 
  • 安装GitLab社区版

    1
    sudo yum install -y gitlab-ce 

    安装成功后会看到gitlab-ce打印了以下图形
    img

异常处理:

出现“policycoreutils-python is needed by问题”,应该是在安装gitlab时,gitlab的版本是centos7的,如果你确定你的centos版本是centos7
​

解决方法:

1
sudo yum installpolicycoreutils-python

如果这个方法无效,你的centos版本一定不是centos7
如果你的centos版本是centos8.那么换一个gitlab版本,也就是重新下载一个,这里是最新地址

1
https://mirrors.tuna.tsinghua.edu.cn/gitlab-ce/yum/el8/

下载命令:

1
wget https://mirrors.tuna.tsinghua.edu.cn/gitlab-ce/yum/el8/gitlab-ce-12.10.1-ce.0.el8.x86_64.rpm

安装:

1
sudo rpm -i gitlab-ce-12.10.1-ce.0.el8.x86_64.rpm

若出现错误“policycoreutils-python-utils is needed by gitlab-ce-12.10.1-ce.0.el8.x86_64”
解决办法:

1
sudo yum install policycoreutils-python-utils

然后重新安装。
​

参考:https://blog.csdn.net/fu18838928050/article/details/107901895

2、配置GitLab站点Url

GitLab默认的配置文件路径是/etc/gitlab/gitlab.rb
默认的站点Url配置项是:

1
external_url 'http://gitlab.example.com'

这里我将GitLab站点Url修改为”external_url ‘http://192.168.0.80:9000”
也可以用IP代替域名,这里根据自己需求来即可

1
2
3
4
5
#修改配置文件
sudo vi /etc/gitlab/gitlab.rb

#配置首页地址(大约在第15行)
external_url 'http://192.168.0.80:9000'

3、启动并访问GitLab

  • 启动GitLab

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    #重新配置并启动
    sudo gitlab-ctl reconfigure

    #完成后将会看到如下输出
    Running handlers complete
    Chef Client finished, 432/613 resources updated in 03 minutes 43 seconds
    gitlab Reconfigured!


    Notes:
    Default admin account has been configured with following details:
    Username: root
    Password: You didn't opt-in to print initial root password to STDOUT.
    Password stored to /etc/gitlab/initial_root_password. This file will be cleaned up in first reconfigure run after 24 hours.

  • 访问GitLab

将设置的域名DNS解析到服务器IP,或者修改本地host将域名指向服务器IP。
访问:http://192.168.0.80:9000
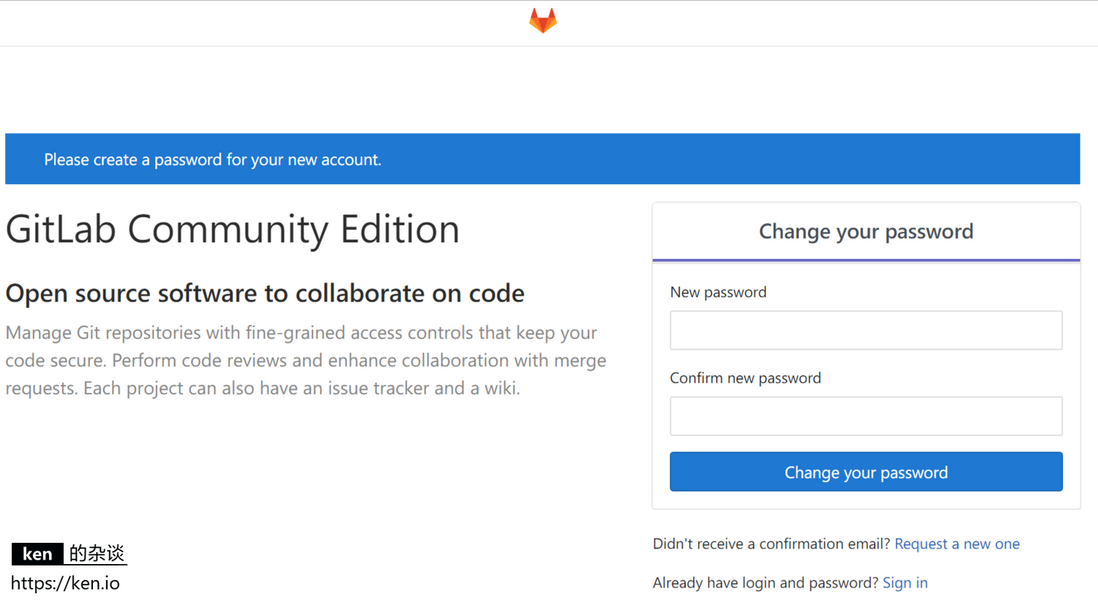
img
这时候会提示为管理员账号设置密码。管理员账号默认username是root。
设置完成之后即可使用root账号登录,登陆后会进入欢迎界面。
img

四、GitLab常用配置

1、邮件配置

配置邮箱可以让GitLab在发生相应事件的时候进行邮件通知
比如配置腾讯企业邮箱如下:

1
2
3
4
5
6
7
8
9
10
11
12
gitlab_rails['smtp_enable'] = true
gitlab_rails['smtp_address'] = "smtp.ym.163.com"
gitlab_rails['smtp_port'] = 465
gitlab_rails['smtp_user_name'] = "caijianbin918@163.com"
gitlab_rails['smtp_password'] = "Qiu918++aa"
gitlab_rails['smtp_domain'] = "smtp.ym.163.com"
gitlab_rails['smtp_authentication'] = "login"
gitlab_rails['smtp_enable_starttls_auto'] = true
gitlab_rails['smtp_tls'] = true
gitlab_rails['gitlab_email_from'] = 'caijianbin918@163.com'


具体参考:
https://docs.gitlab.com/omnibus/settings/smtp.html

SMTP settings | GitLab

2、禁用创建组权限

GitLab默认所有的注册用户都可以创建组。但对于团队来说,通常只会给Leader相关权限。
虽然可以在用户管理界面取消权限,但毕竟不方便。我们可以通过配置GitLab默认禁用创建组权限。

1
2
3
4
5
6
7
8
9
#修改配置文件
sudo vi /etc/gitlab/gitlab.rb

#开启gitlab_rails['gitlab_default_can_create_group'] 选项,并将值设置为false
### GitLab user privileges
gitlab_rails['gitlab_default_can_create_group'] = false

#保存后,重新配置并启动GitLab
sudo gitlab-ctl reconfigure

3.配置代码位置

找到git_data_dirs 选型,配置地址

1
2
3
4
5
git_data_dirs({
"default" => {
"path" => "/data/tools/gitlab/data"
}
})

参考链接:https://docs.gitlab.com/omnibus/settings/configuration.html
​

4.gitlab 备份

1)修改配置文件

1
2
3
4
5
6
7
8
# 打开gitlab配置文件
vim /etc/gitlab/gitlab.rb

#设置备份文件的保存位置
gitlab_rails['backup_path'] = "/data/tools/gitlab/backup"

#设置备份文件的过期时间,单位为秒,默认7天
gitlab_rails['backup_keep_time'] = 604800

执行wq保存后,刷新配置

1
gitlab-ctl reconfigure

2)执行备份命令验证

执行备份命令,去对应的文件路径查看是否已经创建了备份文件

1
gitlab-rake gitlab:backup:create

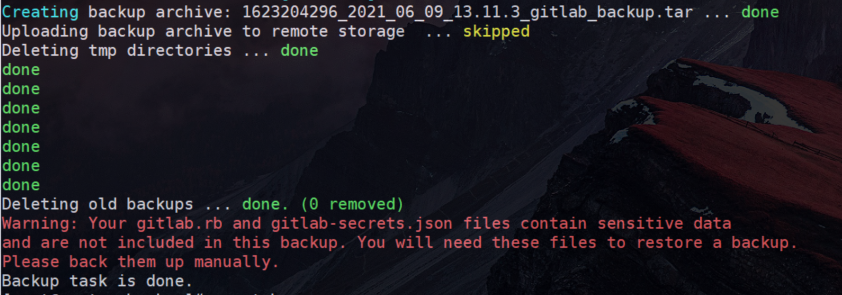
执行打印如下:
企业微信截图_16232053622449.png
红色字体描述为 gitlab.rb 和gitlab-secrets.json为敏感文件需要手动备份
​

3)通过cron定时备份

方法1、在命令行输入: crontab -e 然后添加相应的任务,wq存盘退出。

1
2
3
4
#输入命令crontab -e
crontab -e
#输入相应的任务
0 2 * * * /opt/gitlab/bin/gitlab-rake gitlab:backup:create CRON=1

方法2、直接编辑/etc/crontab 文件,即vim /etc/crontab,然后添加相应的任务

1
2
# edited by ouyang 2017-8-11 添加定时任务,每天凌晨两点,执行gitlab备份
0 2 * * * root /opt/gitlab/bin/gitlab-rake gitlab:backup:create CRON=1

重启cron服务

1
systemctl restart crond.service

5.gitlab-ctl常用命令介绍

命令 说明
check-config 检查在gitlab中是否有任何配置。在指定版本中删除的rb
deploy-page 安装部署页面
diff-config 将用户配置与包可用配置进行比较
remove-accounts 删除所有用户和组
upgrade 升级
service-list 查看所有服务
once 如果GitLab服务停止了就启动服务,如果已启动就不做任何操作
restart 重启GitLab服务
start 如果GitLab服务停止了就启动服务,如果已启动就重启服务
stop 停止GitLab服务
status 查看GitLab服务状态
reconfigure reconfigure重新配置GitLab并启动

参考链接:
https://ken.io/note/centos7-gitlab-install-tutorial

Docker离线部署手册

一、卸载旧的docker

1.检查是否已经安装docker
1
rpm -qa|grep docker

img

2.卸载
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
rpm -e 包名

如果提示无法卸载,则 rpm -e 包名 --nodeps --force 强制卸载

rpm -ivh docker-compose-plugin-2.27.1-1.el7.x86_64

rpm -ivh docker-ce-cli-20.10.16-3.el7.x86_64

rpm -ivh docker-ce-20.10.16-3.el7.x86_64

rpm -ivh docker-scan-plugin-0.23.0-3.el7.x86_64

rpm -ivh docker-buildx-plugin-0.14.1-1.el7.x86_64

rpm -ivh docker-ce-rootless-extras-20.10.16-3.el7.x86_64

二、下载docker以及相关依赖

1.在可以联网的Linux服务器上通过以下命令下载20.10.16版本的docker及其相关依赖
1
yum install docker-ce-20.10.16 --downloadonly --downloaddir=/data/dockerrpm/

img

此处只有 docker-ce 是 20.10.16 ,如果其他 如 docker-ce-cli 等也需要指定版本,可以在下载的时候进行指定,如下指定 docker-ce 和 docker-ce-cli 都安装20.10.16

1
yum install docker-ce-20.10.16 docker-ce-cli-20.10.16 --downloadonly --downloaddir=/data/

三、安装docker

将下载的rpm包全部上传到内网服务器同一目录下

1
直接执行 rpm -ivh *.rpm 会提示冲突,无法安装
1
执行 rpm -ivh *.rpm --force 忽略冲突进行安装
1
安装完成后执行systemctl status docker可以看到docker未启动
1
docker --version 查看版本

docker加速配置

1
2
3
4
5
6
7
8
9
10
11
/etc/docker/daemon.json
{
"registry-mirrors": [
"https://reg-mirror.qiniu.com/",
"https://hub-mirror.c.163.com/",
"https://wjxr9cjk.mirror.aliyuncs.com/",
"https://docker.mirrors.ustc.edu.cn/"
],
"data-root":"/data/middleware/docker/data",
"dns": ["8.8.8.8", "8.8.4.4"]
}

四、Docker服务启停

1
2
3
4
5
6
7
8
查看状态
systemctl status docker
启动docker
systemctl start docker
关闭docker
systemctl stop docker
设置开机自启动
systemctl enable docker

五、Docker离线部署minio(minio-RELEASE.2021-04-22T15-44-28Z)

一、构建minio镜像

1.Dockerfile
1
2
3
4
5
6
7
8
9
10
FROM centos:7
COPY ./minio /usr/local/bin/minio
# 环境变量配置MinIO账号密码
ENV MINIO_ROOT_USER=admin
ENV MINIO_ROOT_PASSWORD=Abc..123!
RUN mkdir -p /var/log/minio
RUN mkdir -p /data/apps/minio/data
RUN chmod +x /usr/local/bin/minio
# 指定容器启动时执行的命令
CMD ["/usr/local/bin/minio", "server", "--address", ":9800", "/data/apps/minio/data"]
2.构建

当前目录结构

1
2
3
4
minidir:
-Dockerfile
-centos7.tar
-minio

构建命令

1
docker build -t minio:v1.0 .
3.启动容器
1
2
3
# 将容器中9800端口映射到宿主机的9801
# 如果在docker启动之后启停过宿主机的防火墙,那么也需要重启docker,否则会报错
docker run -d --name my-minio-container -p 9801:9800 minio:v1.0

linux初始化

一、配置yum加速

备份并清空/etc/yum.repos.d目录下所有文件

1
2
3
4
5
curl -o /etc/yum.repos.d/CentOS-Base.repo http://mirrors.aliyun.com/repo/Centos-7.repo
curl -o /etc/yum.repos.d/epel.repo https://mirrors.aliyun.com/repo/epel-7.repo
yum clean all
yum makecache fast
yum update -y

二、修改hostname

1
hostnamectl set-hostname s172010136016

三、设置时区

1
timedatectl set-timezone Asia/Shanghai

四、磁盘挂载

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
fdisk -l
parted /dev/vdb
parted>mklabel gpt
parted>mkpart primary 0% 100%
parted>print
parted>quit

fdisk -l

mkfs -t ext4 /dev/vdb1

mkdir -p /pldk
cp /etc/fstab /etc/fstab.bak.$(date '+%Y%m%d%H%M%S')

cat >> /etc/fstab << EOF
/dev/vdb1 /pldk ext4 defaults 1 2
EOF

五、密码安全设置

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
vi /etc/login.defs
PASS_MAX_DAYS 90 # 有效期90天
PASS_MIN_DAYS 2 #
PASS_MIN_LEN 12
PASS_WARN_AGE 7

cat /etc/login.defs | grep PASS
cat /etc/pam.d/system-auth | grep pam_tally2
vi /etc/pam.d/system-auth
auth required pam_tally2.so onerr=fail deny=5 unlock_time=300 even_deny_root root_unlock_time=60
省总信创等保测评要求 引用pam.tally2.so模块,并配置登录失败次数3次,账户锁定10分钟
auth required pam_tally2.so onerr=fail deny=3 unlock_time=600 even_deny_root root_unlock_time=60

cat /etc/pam.d/system-auth | grep pam_cracklib
vi /etc/pam.d/system-auth
password requisite pam_cracklib.so difok=4 minlen=12 ucredit=-1 lcredit=-1 dcredit=-1

cat /etc/pam.d/system-auth | grep pam_pwquality
vi /etc/pam.d/system-auth
password requisite pam_pwquality.so try_first_pass local_users_only retry=3 authtok_type= enforce_for_root

cat /etc/pam.d/system-auth | grep pam_pwhistory
vi /etc/pam.d/system-auth
password required pam_pwhistory.so enforce_for_root remember=5

cat /etc/security/pwquality.conf | grep -E "minlen|minclass|credit"
cat /etc/security/pwquality.conf | grep minclass
cat /etc/security/pwquality.conf | grep credit

六、设置ssh连接时长

1
2
3
4
5
6
7
cat /etc/profile | grep TMOUT

vi /etc/profile
export TMOUT=300
readonly TMOUT

source /etc/profile

七、配置新用户并赋予sudo

1
2
3
4
5
useradd -m ywfw

chmod -v u+w /etc/sudoers
echo 'user1 ALL=(ALL) ALL'>>/etc/sudoers
chmod -v u-w /etc/sudoers

八、实时同步时间

1
2
3
yum install -y ntp
*/30 * * * * /usr/sbin/ntpdate 172.10.254.20 >> /var/log/ntpdate.log 2>&1 &
*/30 * * * * /usr/sbin/ntpdate ntp.aliyun.com >> /var/log/ntpdate.log 2>&1 &

九、禁止root远程登录

1
2
3
vi /etc/ssh/sshd_config
PermitRootLogin no
systemctl restart sshd

十、关闭selinux

1
2
3
4
5
6
7
8
#关闭selinux
sed -i.bak 's/SELINUX=enforcing/SELINUX=disabled/' /etc/selinux/config

#检查是否有关闭成功
grep SELINUX=disabled /etc/selinux/config

#临时修改
setenforce 0

十一、字符集设置

1
2
3
4
5
6
7
8
9
10
11
#英文字符集
locale set-locale LANG="en_US>UTF-8"
echo $LANG

#设置系统的区域设置为美国英语(en_US),并指定字符编码为 UTF-8。
#并检查是否有设置成功

#PS:设置中文字符集可以安装中文语言包
yum install -y zh_CN.koi8u

locale set-locale LANG="zh_CN.UTF-8"

CentOS 7 的优化可以包括多个方面,以下是一些基本的优化步骤:

更新系统:

sudo yum update -y

安装EPEL仓库:

sudo yum install epel-release -y

安装必要的工具:

sudo yum install vim htop net-tools -y

调整文件描述符限制:

编辑/etc/security/limits.conf,添加或修改以下行:

  • soft nofile 65535
  • hard nofile 65535
  • soft nproc 65535
  • hard nproc 65535

关闭不必要的服务:

sudo systemctl stop postfix
sudo systemctl disable postfix

设置时区:

sudo timedatectl set-timezone Asia/Shanghai

配置防火墙(如firewalld):

sudo systemctl start firewalld
sudo systemctl enable firewalld
sudo firewall-cmd –permanent –add-service=http
sudo firewall-cmd –reload

优化SSH配置:

编辑/etc/ssh/sshd_config,例如禁用DNS反向解析可以提高SSH登录性能:

UseDNS no

然后重启SSH服务:

sudo systemctl restart sshd

调整内核参数(可选,高级用户):

编辑/etc/sysctl.conf,添加或修改内核参数,例如:

net.ipv4.ip_local_port_range = 1024 65535

应用新的内核参数:

sudo sysctl -p

创建备份和清理系统:

sudo tar cvpzf /backup.tgz –exclude=/backup.tgz –one-file-system /

这些是基本的系统优化步骤,具体根据您的服务器用途和需求可能还需要进行更多的优化。